Hive元数据存储与管理服务 数据处理与存储的基础设施
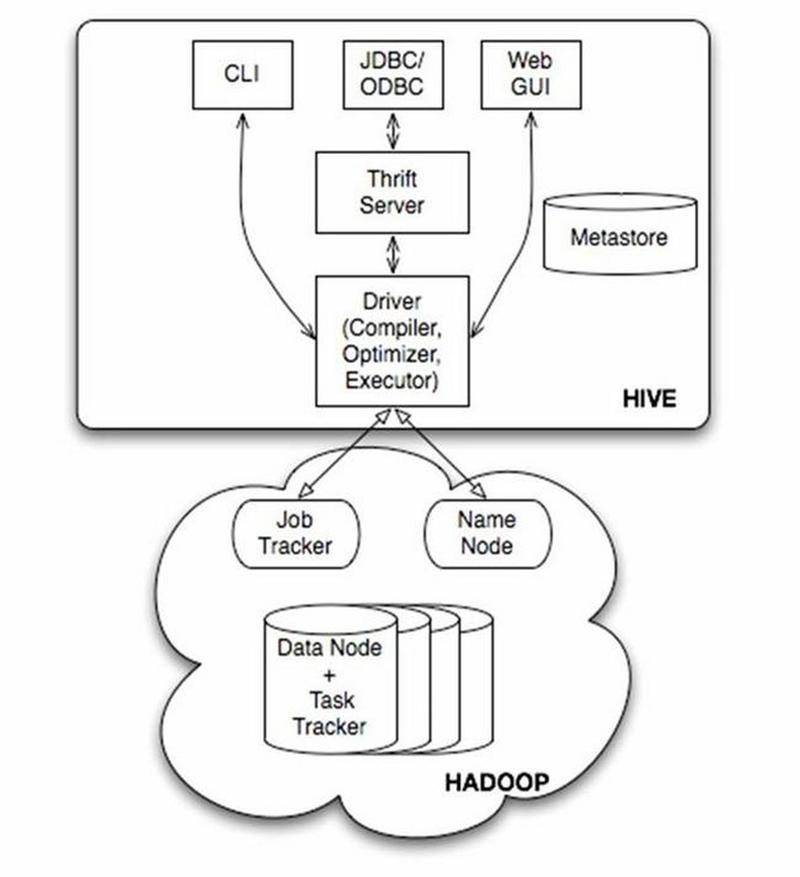
概述\n\nHive元数据存储和管理服务(Hive Metastore,以下简称HMS)是Hadoop与Hive生态系统中的核心组件之一,专门用于存储和管理与Hive表、列、分区等对象相关的元数据信息。它也是一项重要的数据处理与存储服务,为各类上层计算引擎和分析工具提供统一、可靠的元数据访问能力。\n\n## 元数据存储的核心对象\n\nHMS主要负责存储以下三类元的元数据描述:\n\n1. 表(Table):Hive表的名称、类型(内部表/外部表)、存储位置(HDFS路径)、输入输出格式、SerDe序列化方式、列分隔符等信息。\n2. 列(Column):每一张表的字段名称、数据类型、注释、列顺序、以及是否作为分区键等属性。\n3. 分区(Partition):针对分区表,记录各分区的分区键值与实际存储路径的映射关系,从而让我们在建表和查询时快速定位数据。\n\n除此之外,HMS还可以存储数据库(Database)、视图(View)、索引、用户与权限等元数据。\n\n## 架构设计与存储后端\n\nHMS通常采用两个关键组成部分:\n\n- 元数据服务层:对外提供Thrift接口,供Hive、Spark SQL、Presto、Impala等计算引擎以及调度工具调用,实现元数据的增删改查。\n- 元数据存储层:借助关系型数据库(如MySQL、PostgreSQL、Oracle等)持久化存储元数据记录,也可以使用Derby作为嵌入式的轻量级方案用于测试或单机。在数据库之上加之备份与事务等手段,保障元数据的一致性和全局有序性。\n\n在日常环境中往往多克隆一个HA结构,使元数据存储相关操作能以负载均衡列表完成副本以提高查询体验。当然这类操作内部常常要依赖分布式结点做master-based id发送选活构型。\n\n## 作为数据处理和存储服务\n\nHMS的优势要点并不能如此完整概括的就是上面的\
如若转载,请注明出处:http://www.dachenzhihui.com/product/18.html
更新时间:2026-11-01 12:30:49