大数据入门(中) 大数据技术辨析——数据处理和存储服务
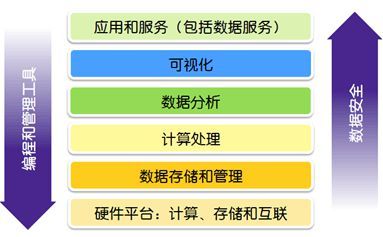
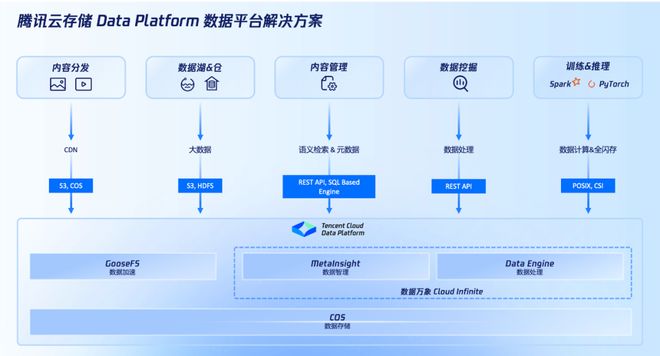
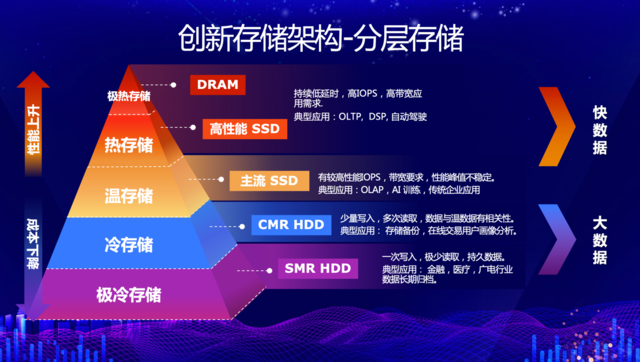
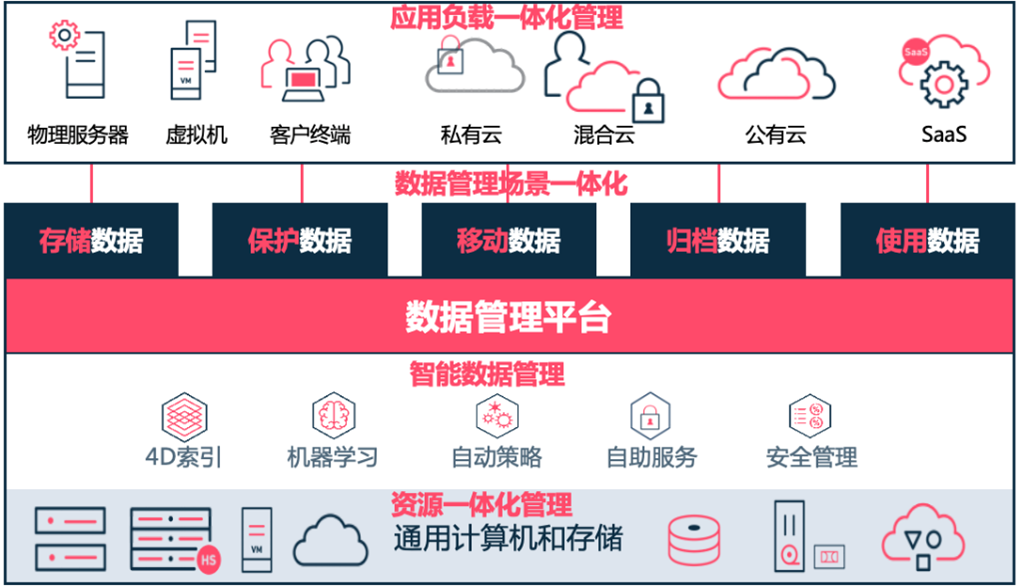
在上一篇文章中,我们探讨了大数据的基本概念、特征以及与传统数据处理的区别。我们认识到,大数据不仅仅是“大量的数据”,更是一套涵盖采集、存储、处理、分析、应用等环节的完整技术体系。本篇将聚焦于大数据技术体系中的两大核心支柱:数据处理和存储服务,辨析其技术内涵、关键组件及选型考量,帮助读者构建清晰的技术认知框架。\n\n## 一、数据处理服务:从批处理到实时流\n\n数据是原料,处理是加工。大数据处理的核心目标是从海量、多源、异构的数据中高效提取价值。根据对时效性的要求,数据处理主要分为批处理(Batch Processing)和流处理(Stream Processing)两种模式;根据处理引擎的架构,又可分为传统MapReduce体系与基于内存的DAG(有向无环图)体系。\n\n### 1. 批处理技术\n\n批处理适用于对历史全量数据的离线分析,强调高吞吐、高容错,但对延迟不敏感。典型代表是Apache Hadoop MapReduce和Apache Spark。\n\n- Hadoop MapReduce:基于“分而治之”思想,将计算分为Map和Reduce两个阶段,中间结果落盘,容错性强但磁盘I/O开销大,适合超大规模数据的离线处理。\n- Apache Spark:基于内存计算和DAG调度,将中间结果保留在内存中,大幅减少磁盘读写,处理速度比MapReduce快一个数量级以上。Spark提供了Spark SQL、Spark Streaming、MLlib、GraphX等组件,支持批处理、流处理、机器学习、图计算等多种场景,已成为批处理的事实标准。\n- 其他批处理框架:如Apache Flink(也支持批处理,但以流处理见长)、Apache Tez(优化MapReduce的DAG执行引擎)等。\n\n技术辨析:MapReduce更侧重于极致的容错与scale-out能力,适合对延迟要求极低的夜间批处理作业;Spark则以内存计算为核心,在迭代计算和交互式查询场景优势明显,但需注意内存管理调优。实际选型中,Spark已基本取代MapReduce成为批处理主流,但MapReduce作为Hadoop生态的底层基石仍有其存在价值(例如HBase的某些底层操作仍依赖它)。\n\n### 2. 流处理技术\n\n流处理处理的是无界数据流,要求低延迟(毫秒到秒级)和高时效性,适用于实时监控、实时风控、实时推荐等场景。\n\n- Apache Storm:早期流处理框架,纯粹的流式计算,延迟极低但吞吐量有限,且不支持事件时间(Event Time)和窗口操作,状态管理较弱。\n- Apache Spark Streaming:微批处理(Micro-batch)模式,本质上是将流数据切分为小批次用Spark引擎处理,延迟在秒级,吞吐量高,可与批处理代码复用。但相比纯流处理框架,延迟略高。\n- Apache Flink:真正的流处理引擎,以流计算为核心,支持事件时间、状态管理、精确一次(Exactly-once)语义,延迟可达毫秒级,同时也能处理批数据(作为有界流)。Flink已成为流处理领域的标杆。\n- Apache Kafka Streams:构建在Kafka之上的轻量级流处理库,适合与Kafka紧密集成的场景,提供简单的DSL,但不具备Flink那样的集群管理和高级特性。\n\n技术辨析:Spark Streaming采用微批模式,延迟与批次间隔相关,适合对延迟要求不极端(秒级)的准实时场景;Flink采用原生流处理,对事件时间和乱序数据处理支持完备,是严格实时场景的首选。Storm因其设计较早,复杂状态和语义支持不足,已逐渐被Flink和Spark Streaming替代。\n\n### 3. 统一处理引擎趋势\n\n批流统一成为趋势。Flink提出“批是流的特例”的理念,在同一引擎上支持批处理和流处理;Spark也通过Structured Streaming(基于Spark SQL引擎)实现流批一体。站在技术选型角度,如果团队需要同时覆盖实时和离线场景,Flink是理想选择;如果已有Spark生态(如Spark SQL、MLlib),Structured Streaming能以较低学习成本实现流处理。\n\n## 二、数据存储服务:从文件系统到NoSQL\n\n大数据的存储面临海量数据、高并发访问、多类型数据(结构化、半结构化、非结构化)、高可用与扩展性等挑战。因此,涌现了以分布式文件系统为基础的多样化存储技术。\n\n### 1. 分布式文件系统\n\n- HDFS(Hadoop Distributed File System):Hadoop生态的底层存储,采用主从架构(NameNode+DataNode),将文件切分为块(默认128MB)多副本存储,支持高吞吐的顺序读写,适合一次写入、多次读取的大文件场景。但不适合大量小文件、低延迟随机读写。\n- 其他文件系统:如Ceph(统一分布式存储,支持对象、块、文件接口)、GlusterFS等,常用于云原生和通用存储场景。\n\n### 2. NoSQL数据库\n\nNoSQL强调水平扩展、灵活数据模型和高可用,弥补了关系型数据库在大数据场景的不足,主要分为四类:\n\n- 键值存储(Key-Value):以Redis和Apache HBase为代表。\n - Redis:内存数据库,支持持久化,适用于缓存、会话存储、实时计数器等高并发低延迟场景。\n - HBase:构建在HDFS之上,列式存储,支持海量数据的随机实时读写,适合稀疏数据表,常作为大数据平台中的在线查询存储(如用户画像、时序数据)。\n- 文档数据库(Document):如MongoDB,以JSON/BSON格式存储文档,模式灵活,适合内容管理、日志收集、商品目录等半结构化场景。\n- 列式数据库(Wide Column):如Apache Cassandra,强调高可用和最终一致性,适合写密集型场景(如IoT传感器数据、消息记录)。\n- 图数据库(Graph):如Neo4j,专门处理节点与关系,适合社交网络、知识图谱、欺诈检测等场景。\n\n技术辨析:HBase是强一致性(基于行级事务),读写延迟在毫秒级,但依赖HDFS和ZooKeeper,运维复杂度较高;Cassandra为最终一致性(可调),写性能极佳但读取可能稍慢,适合跨数据中心部署。MongoDB在文档模型和查询灵活性上占优,但不适合强事务场景。Redis是纯内存型,速度快但容量受内存限制,常用作缓冲层。\n\n### 3. 数据湖与湖仓一体\n\n传统数据仓库难以应对海量非结构化数据,数据湖应运而生。\n\n- 数据湖:以原始格式存储所有类型数据(通常存于HDFS或对象存储如S3),按需schema-on-read。但数据湖存在“数据沼泽”风险(即缺乏治理导致数据不可用)。\n- 湖仓一体(Lakehouse):结合数据湖的灵活性和数据仓库的schema管理与性能优化,典型代表包括Apache Hudi、Iceberg、Delta Lake,它们在数据湖上增加了ACID事务、时间旅行、schema演进和数据索引等能力,成为当前大数据存储架构的热点。\n\n技术辨析:Hudi侧重增量处理与近实时入湖,Iceberg强调表格式的开放标准与查询性能,Delta Lake与Spark深度绑定。选型时需考虑与现有计算引擎的集成度及团队熟悉度。\n\n## 三、技术选型思路\n\n面对众多技术组件,选型应回归业务需求:\n\n1. 数据时效性:实时优于批处理。推荐选Flink(真流)—Kafka—Redis/HBase/Hudi链路;离线→夜间或定期→Spark on HDFS/数据湖。\n2. 数据规模与访问模式:超大数据文件批量分析用HDFS;高频点查、随机写用HBase/Cassandra;极致低延迟缓存用Redis;半结构化日志用MongoDB。\n3. 一致性与事务要求:强一致性选HBase/MongoDB;弱一致性可用Cassandra等。\n4. 生态与团队经验:如已有Spark投资,优先Spark SQL和Structured Streaming;若有Flink基础,用Flink实现流批一体化。\n5. 运维负担:托云服务(如AWS EMR、阿里云EMR)可降低组件堆叠的运维复杂度。\n\n## 四、\n\n数据处理与存储是大数据技术栈的两大基石。批处理与流处理的边界正在归 装模—批流融合(如Flink、Spark Structured Streamin);存储方面则从HDFS+N0SQL向数据湖、湖仓一体演进。理解这些技术的设计定位与取舍,而非盲目追求“最新”,才能构建出高效可靠的大数据架构。下一篇,我们将对作业调度与资源管理、数据集成技术入口进行分析。
如若转载,请注明出处:http://www.dachenzhihui.com/product/22.html
更新时间:2026-11-01 05:09:31